
DeepSeek 开源 DeepInfer:把线上推理集群经验交给开发者
DeepInfer 把 DeepSeek 线上推理的并行、调度与重算策略公开出来,但它的适用面也明显偏向单一模型和特定硬件。
网站介绍
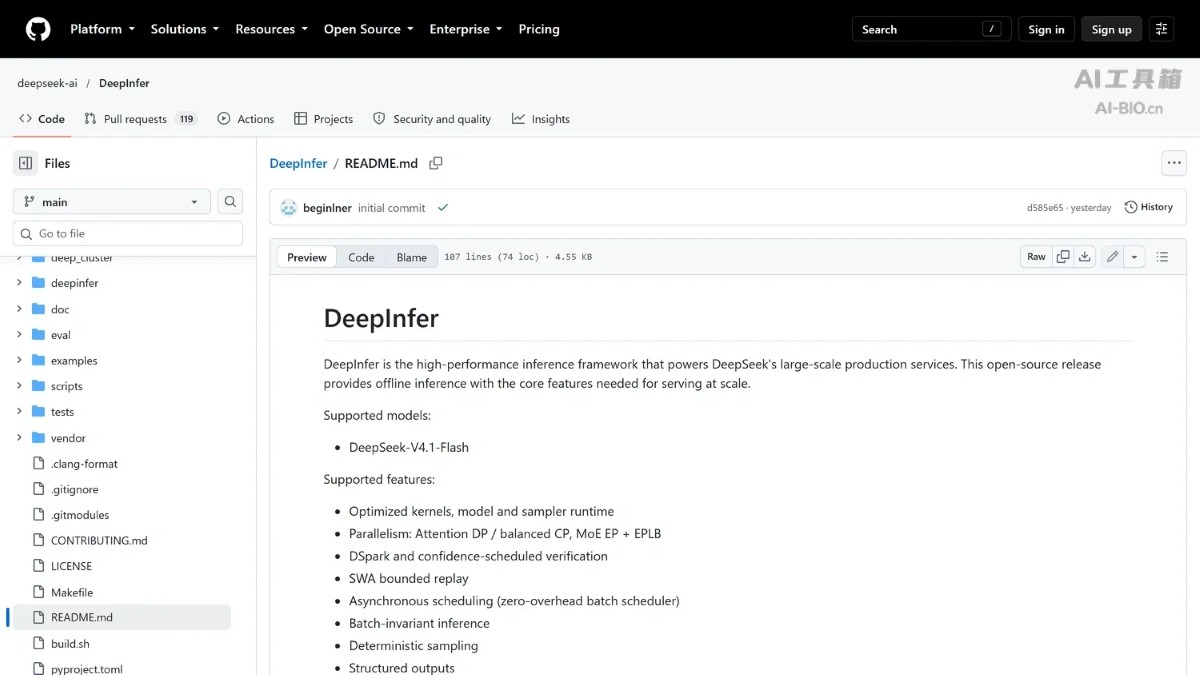
大模型推理的竞争,正在从“能不能跑”转向“怎样把集群用满”。DeepSeek 开源的 DeepInfer,试图把线上服务里积累的并行与调度经验,整理成一套可复用的推理框架。
两层结构:算子和集群
DeepInfer 可以拆成两层看:底层是注意力、矩阵乘、专家通信等高性能算子,上层是模型运行时、采样器和集群调度。它把此前分散发布的算子库按生产调用顺序串起来,目标不是做一个通用模型框架,而是让自家模型在集群上跑得更稳。
几个关键设计
- 两段式并行:Prefill 阶段使用较小规模的专家并行,Decode 阶段切到更大范围的 Wide-EP,分别优化吞吐和延迟。
- 推测解码:用草稿 token 加速生成,再按置信度决定验证长度,在速度和质量之间做取舍。
- SWA 有界重放:只回放最近一段上下文,把重算成本压到相对固定的范围。
- 异步调度:让 CPU 侧批处理与设备侧执行重叠,减少调度空转。
- 结果可复现:批次不变推理和确定性采样,适合评测与效果对照。
- 结构化输出:把生成约束在正则、JSON Schema 或 EBNF 中,便于工具调用和表单填写。
硬件与使用边界
官方支持英伟达 SM100 和昇腾 950,昇腾侧需要对应的 CANN 版本。框架以 Apache-2.0 开源,但目前主要服务 DeepSeek-V4.1-Flash,需要按源码构建,并不是装好就能接所有模型的通用方案。
适合谁
手里有 GPU 或昇腾集群、希望自建私有化推理服务的企业,以及需要复现官方吞吐数据的团队,更适合研究 DeepInfer。只想快速接入多家模型的团队,通用推理框架仍然更省事。
本文根据公开资料整理,具体功能、价格与开放范围请以官方最新说明为准。
评论 0
友善发言,共建温暖社区