MMLU
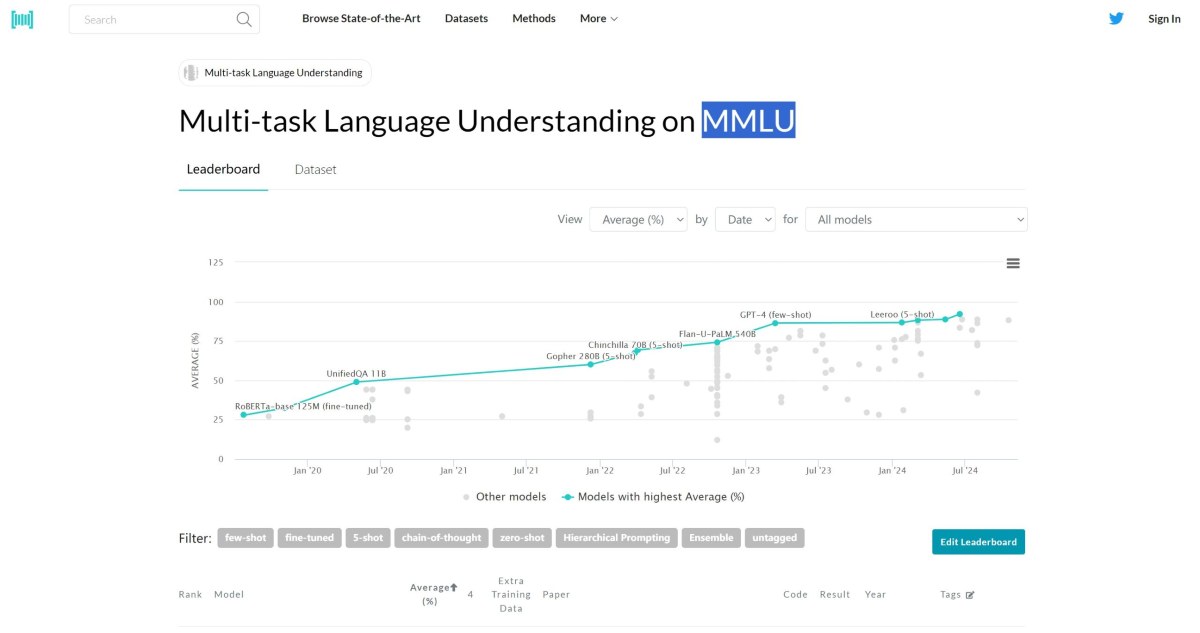
MMLU(Massive Multitask Language Understanding)覆盖 STEM、人文、社科等 57 个学科,用多选题评估模型的知识与推理能力。
站点信息
- 网站名称MMLU
- 官方网址https://paperswithcode.com/sota/multi-task-language-understanding-on-mmlu
- 所属分类AI测评
- 收录时间2026-10-23
- 累计浏览13 次
- 收录者管理员
SEO 查询
网站介绍
MMLU(Massive Multitask Language Understanding)覆盖 STEM、人文、社科等 57 个学科,用多选题评估模型的知识与推理能力。
主要功能
MMLU 的功能主要集中在多领域评估、多任务测试、标准化评测、支持研究和开发、跨文化理解等方向,适合多学科知识、推理评估和模型对比。
多领域评估:MMLU涵盖了57个不同学科的任务,包括数学、历史、计算机科学、法律等,能够全面评估模型在多领域的知识理解和推理能力。
多任务测试:该基准通过多种类型的任务,从简单的常识性问题到复杂的学术问题,测试模型在不同任务上的表现。
标准化评测:MMLU提供了一个标准化的评测框架,使研究人员和开发者能够在全球范围内比较不同模型的性能。
支持研究和开发:MMLU为研究人员和开发者提供了一个标准化的测试基准,方便他们评估和优化模型。
跨文化理解:MMLU的多语言版本(如MMMLU)能够评估模型在不同文化背景下的语言理解和推理能力。
适合哪些人
学术研究:研究人员可以使用MMLU评估不同语言模型在多任务、多领域的表现,推动自然语言处理(NLP)领域的发展
模型开发:开发者可以利用MMLU优化模型的推理能力和知识理解能力,提升模型的综合性能
企业应用:企业可以通过MMLU选择最适合其业务需求的语言模型,优化智能客服、内容生成等应用场景
教育领域:教育机构可以利用MMLU评估模型在教育领域的适用性,例如智能辅导、语言学习等
跨语言评估:通过多语言版本(如MMMLU),评估模型在不同语言和文化背景下的表现
评测结果受数据版本、提示词和运行环境影响,不能单独作为模型选型依据。
价格与免费额度
开源基准免费,论文/代码按原项目许可使用。
怎么用
数据集下载: 访问MMLU数据集的官方页面,下载相应的数据集文件。 如果使用OpenCompass进行评测,可以从其GitHub页面获取相关数据集。
环境准备: 创建一个新的Python环境(如使用Conda): conda create --name mmlu python=3.10 conda activate mmlu 安装必要的依…
加载模型和数据集: 使用Hugging Face的transformers库加载预训练模型和标记器。 加载MMLU数据集: from datasets import load_dataset…
运行评估: 使用pipeline函数对模型进行评估: from transformers import pipeline model_name = "bert-base-uncased" #…
分析结果: 根据评估结果分析模型在不同任务上的表现,生成详细的报告。
常见问题
MMLU的评测任务有哪些?
MMLU包含57个不同学科的任务,涵盖数学、历史、计算机科学、法律等多个领域。
MMLU的评测方式有哪些?
MMLU支持零样本(Zero-shot)和少样本(Few-shot)两种评测方式。
MMLU是否支持多语言评估?
是的,MMLU的多语言版本(如MMMLU)支持多种语言的评估,包括阿拉伯语、德语、斯瓦希里语等。
MMLU的评测结果如何呈现?
评测结果通常以准确率(Accuracy)的形式呈现,展示模型在不同任务上的表现。
MMLU的局限性是什么?
MMLU中的问题大多是知识驱动的,对推理能力的测试有限。 部分问题存在干扰选项较少或标注错误的情况,可能导致评测结果的偏差。
总结
MMLU 适合多学科知识、推理评估和模型对比。优势是「多领域评估」和「多任务测试」;涉及商用或引用时,以官网和原始论文条款为准。
注:以上信息整理自公开资料,具体功能、价格、免费额度与授权政策请以 MMLU 官方最新说明为准。
评论 0
友善发言,共建温暖社区