
科大讯飞发布 SparkAudio 1.0,把翻译、识别和语义理解合进一个语音模型
语音模型的竞争,正在从“识别准不准”转向“能不能听懂场景”。
网站介绍
把翻译、识别和语义理解放进同一个模型,会带来什么变化?讯飞给出的答案是:不只转写文字,还要判断谁在说、在什么环境说、想表达什么。
一个模型做多件事
SparkAudio 1.0 把机器翻译、语音识别和语义理解合并到同一套语音基座里。官方演示用电影片段展示它能分辨声音内容、背景、说话人性别,并判断场景;在实时说话人分离、环境理解、音频理解和情绪识别上也有针对性优化。
产品已经落地
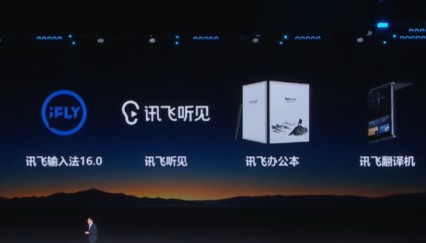
这项能力已经进入讯飞输入法 16.0、讯飞听见、讯飞办公本和讯飞翻译机,支持中英文切换和说话人实时识别。配套发布的“讯飞 AI 录音环”采用 4+1 环麦阵列和 Wi-Fi 6 传输,官方称综合识别准确率超过 96%,2 小时录音转写约需 2 分钟。
语音入口的下一战
真实环境里的噪声、多人同时说话、口音和情绪,比实验室音频难得多。SparkAudio 1.0 的价值在于把“听清”推进到“听懂”,但隐私、离线能力和多语种覆盖仍是长期考题。
本文根据公开资料整理,具体功能、价格与开放范围请以官方最新说明为准。
评论 0
友善发言,共建温暖社区