
腾讯混元开源 Hy-Memory 2.0:给智能体装上三层记忆
智能体能不能长期办事,很大程度取决于它记得住什么、什么时候该忘。Hy-Memory 2.0 给出的答案是按场景拆记忆。
网站介绍
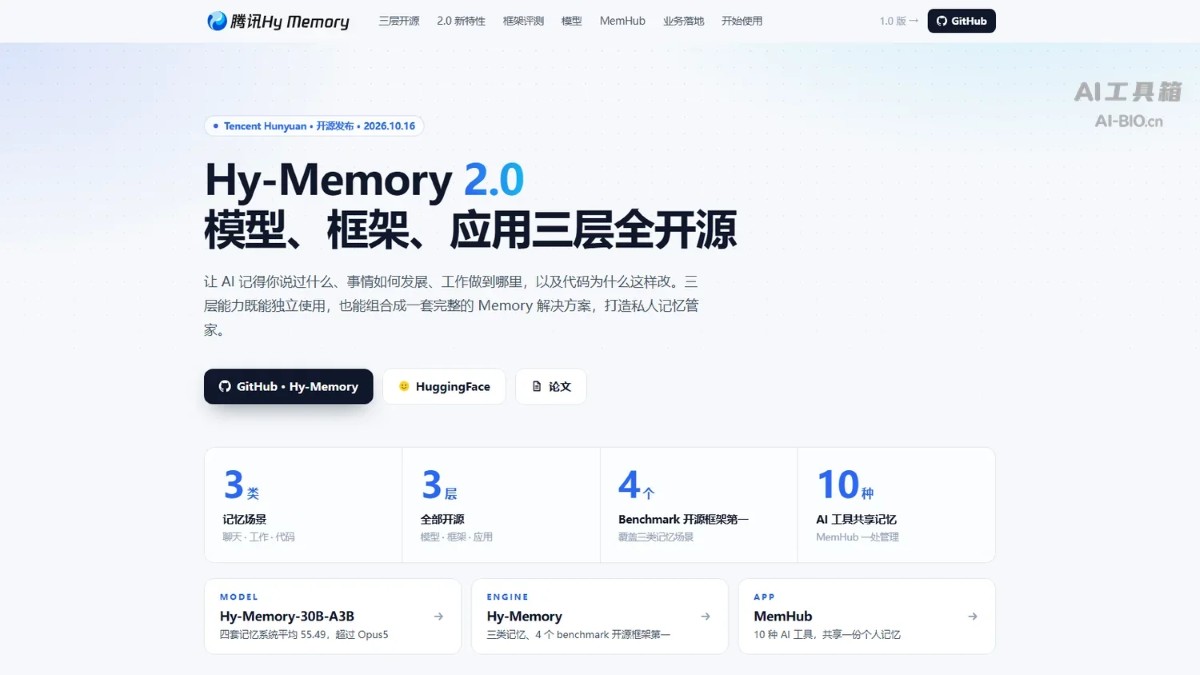
上下文窗口再大,也不等于会管理记忆。腾讯混元开源的 Hy-Memory 2.0,把“记什么、怎么取、何时更新”拆成模型、框架和桌面应用三层,试图给智能体一套更稳定的长期记忆。
三层结构解决什么问题
最上面是 MemHub 本地应用,中间是记忆框架,底层是专用记忆模型。框架按任务类型把记忆分成聊天、工作、代码三条流水线,写入和检索先经过场景路由,再进入对应的记忆结构。
三类记忆的设计
- 聊天记忆:从原始对话逐层抽象,包含基础信息、原子事实、会话摘要、心智模型和前瞻意图。事实带版本,新旧说法不会互相覆盖。
- 工作记忆:每次会话固定写一条事实,记录任务、做法和结果;经验层只保留通过价值阈值的方法,并注明适用环境与置信度。
- 代码记忆:记录文件、函数和分支等坐标,不直接粘贴代码;另挂一条版本演进链,保留被回滚或不在当前分支上的修改。
运行模式与接入
框架提供 lite、pro、ultra 三档:lite 只做向量检索,pro 增加抽取和冲突合并,ultra 再加入结构归纳与跨领域扫描。存储可以替换为 ChromaDB、Qdrant、FAISS 以及 Kuzu、Neo4j,接入只需兼容 OpenAI 协议的模型端点和 embedding 端点。项目采用 Apache-2.0 许可,并提供 Python SDK 与 MCP 插件。
适合谁,注意什么
长期运行的客服、办公和编码智能体都能受益,企业也可以用它补上跨会话记忆。但记忆越多,隐私、成本和错误累积的风险越高;上线前要明确哪些信息可以长期保存,并定期检查检索结果是否仍然准确。
本文根据公开资料整理,具体功能、价格与开放范围请以官方最新说明为准。
评论 0
友善发言,共建温暖社区