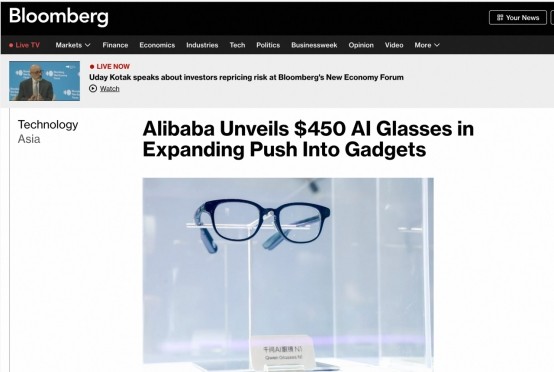
千问 AI 眼镜和耳夹耳机出海,海外开发者先试了翻译
AI 硬件的卖点不只是参数,而是能不能在真实交流里“无感”地帮上忙。
AI 硬件的卖点不只是参数,而是能不能在真实交流里“无感”地帮上忙。
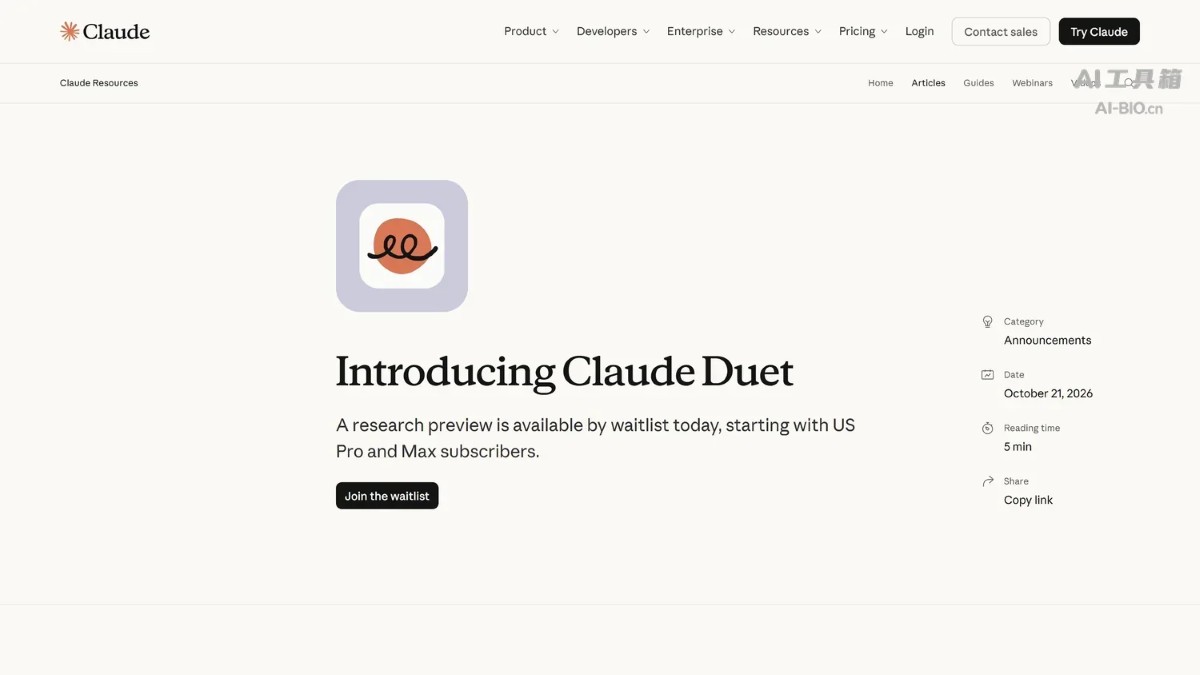
Claude Duet 把 AI 助手从“等你提问”推进到“主动办事”,但权限与审批仍是它能否落地的关键。
从基础模型到内容入口,再到具身智能,今天的 AI 动态都指向同一个方向:能力正在进入具体场景。
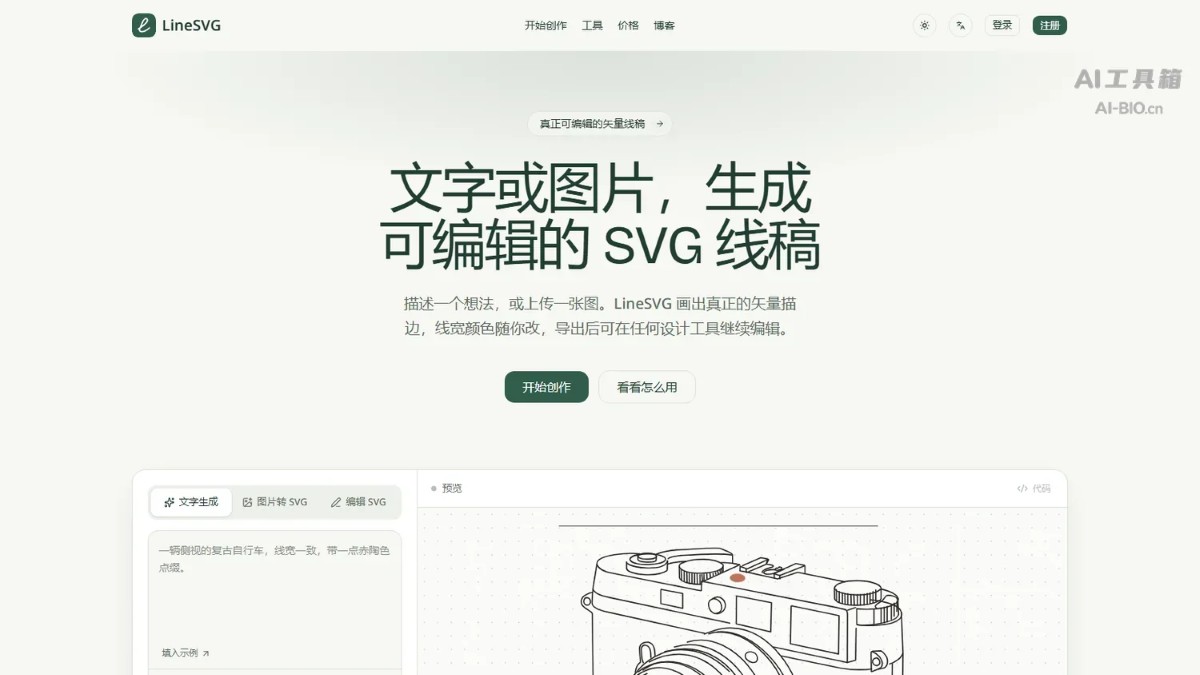
LineSVG 的差异点不是“生成一张图”,而是输出可以继续编辑的矢量路径。
星火 X2.6 最醒目的标签不是参数,而是“全国产算力训练”和“1M 上下文”同时出现。
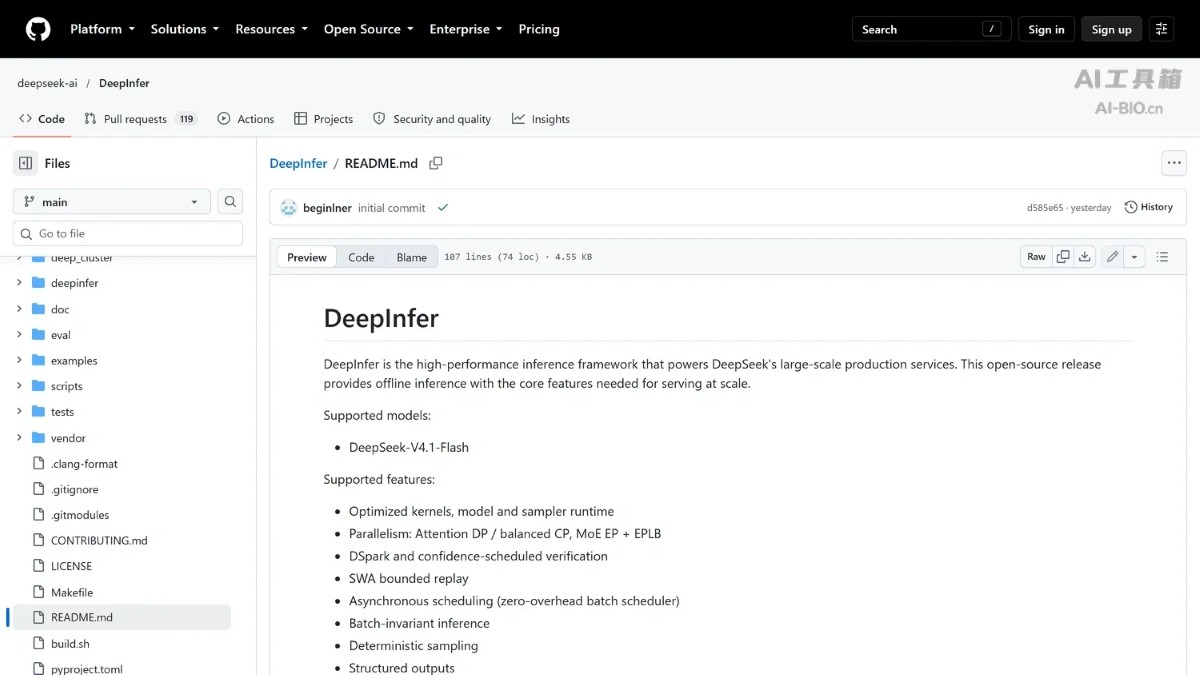
DeepInfer 把 DeepSeek 线上推理的并行、调度与重算策略公开出来,但它的适用面也明显偏向单一模型和特定硬件。
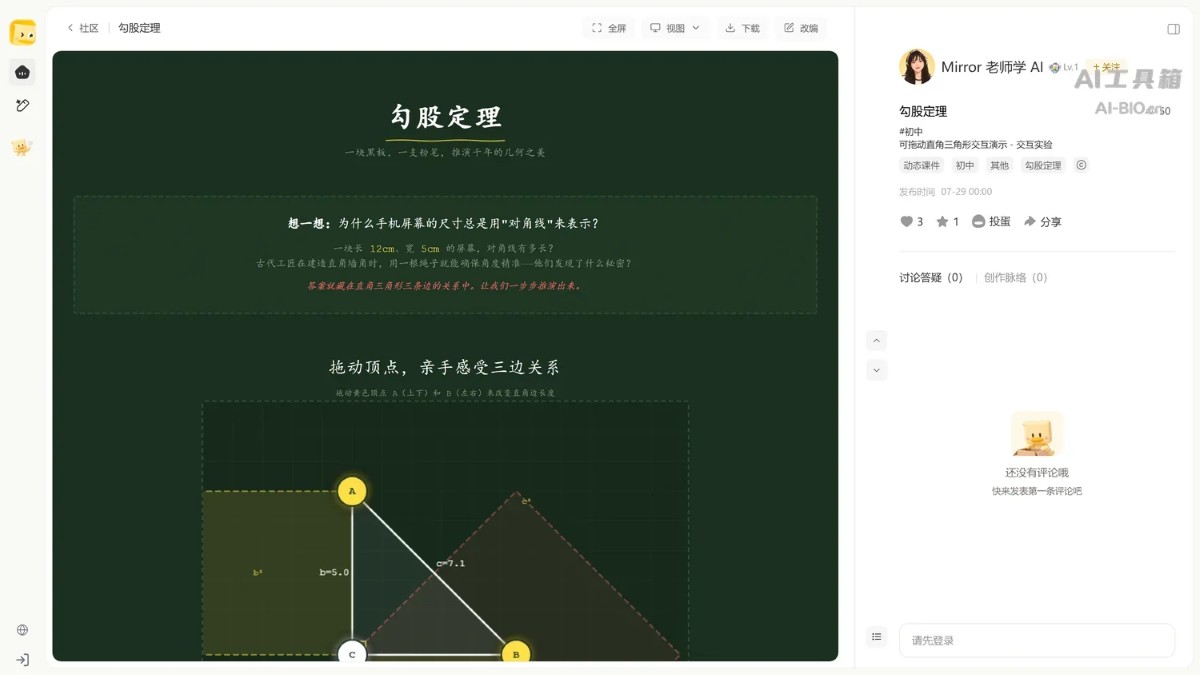
懂了鸭把 AI 生成从“写一段答案”推向“做一件能操作的作品”,课堂和亲子科普是它最直接的使用场景。
语音模型的竞争,正在从“识别准不准”转向“能不能听懂场景”。
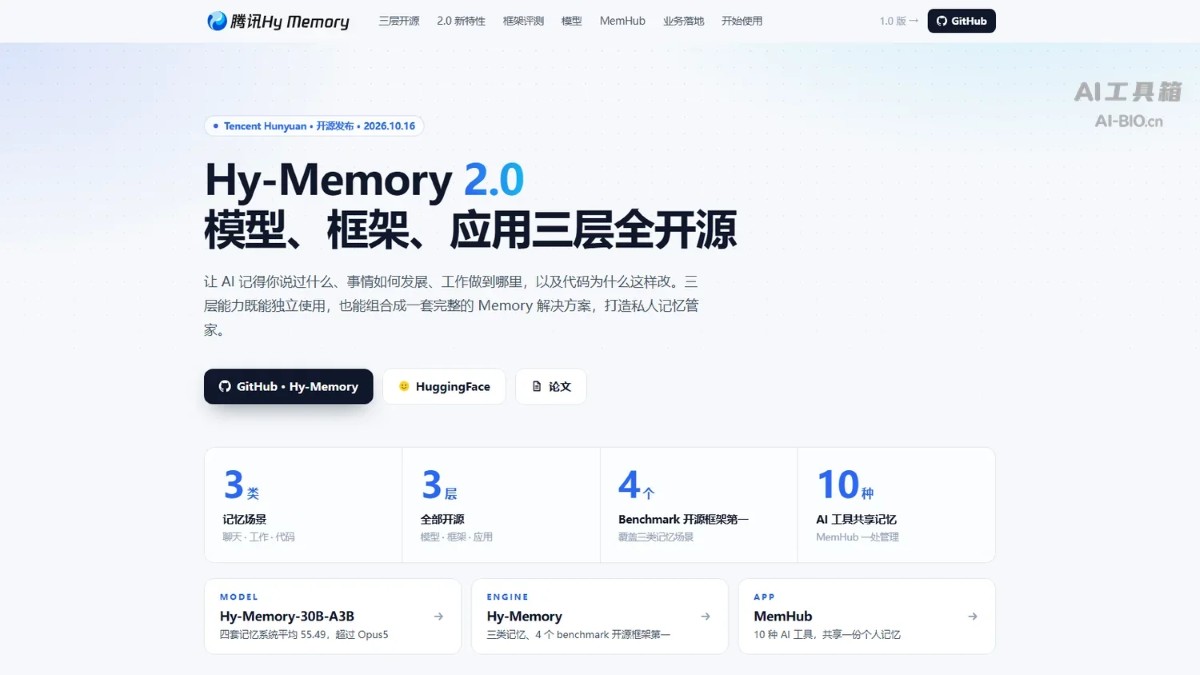
智能体能不能长期办事,很大程度取决于它记得住什么、什么时候该忘。Hy-Memory 2.0 给出的答案是按场景拆记忆。
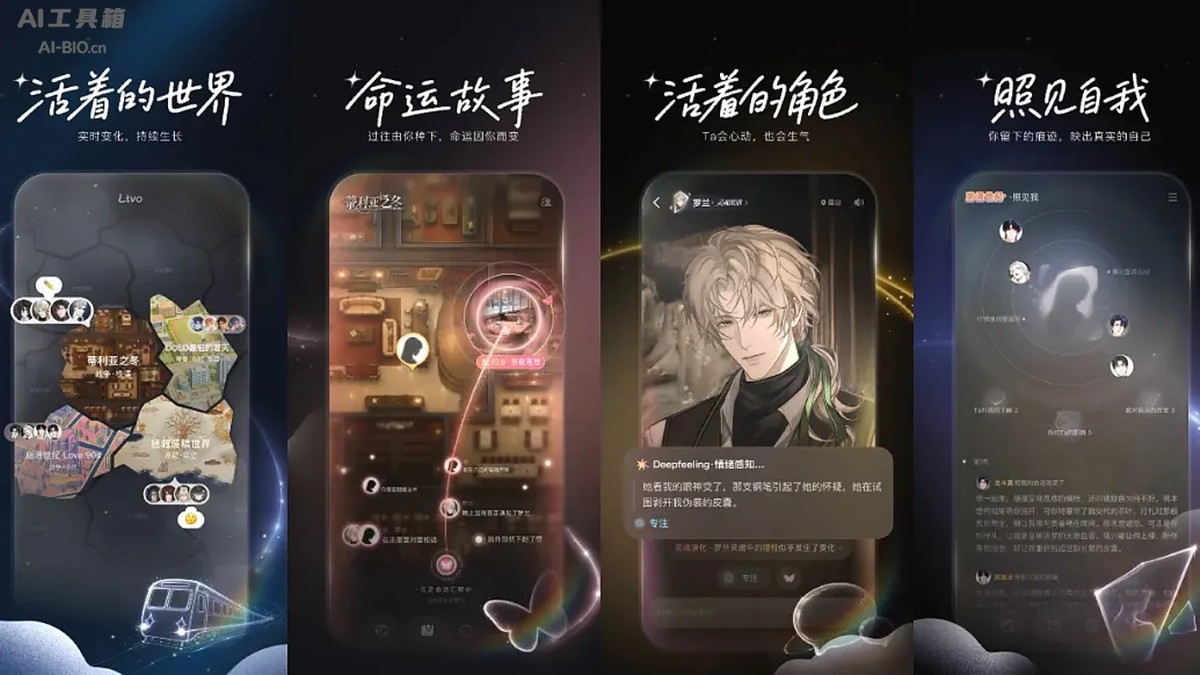
Livo 把角色陪伴做成“世界先运转,用户再进入”,它刻意保留了等待、错过和不可撤回的选择。
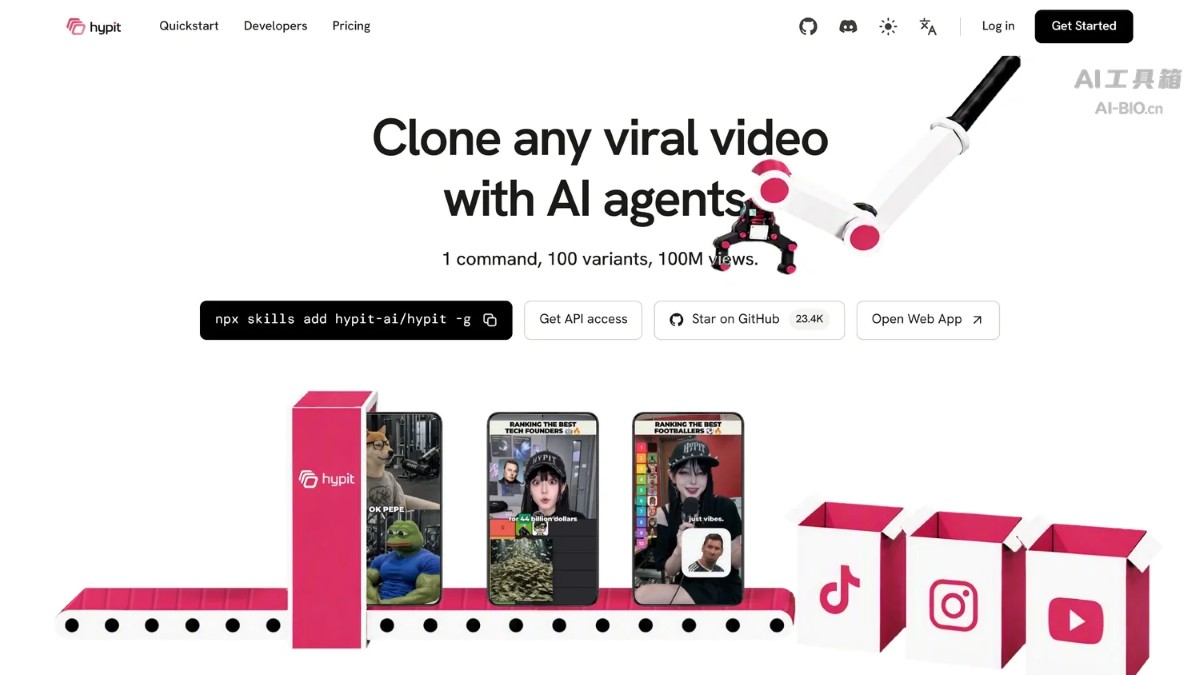
Hypit 的关键不是“生成一段视频”,而是把一条验证过的视频结构变成可重复执行的生产线。
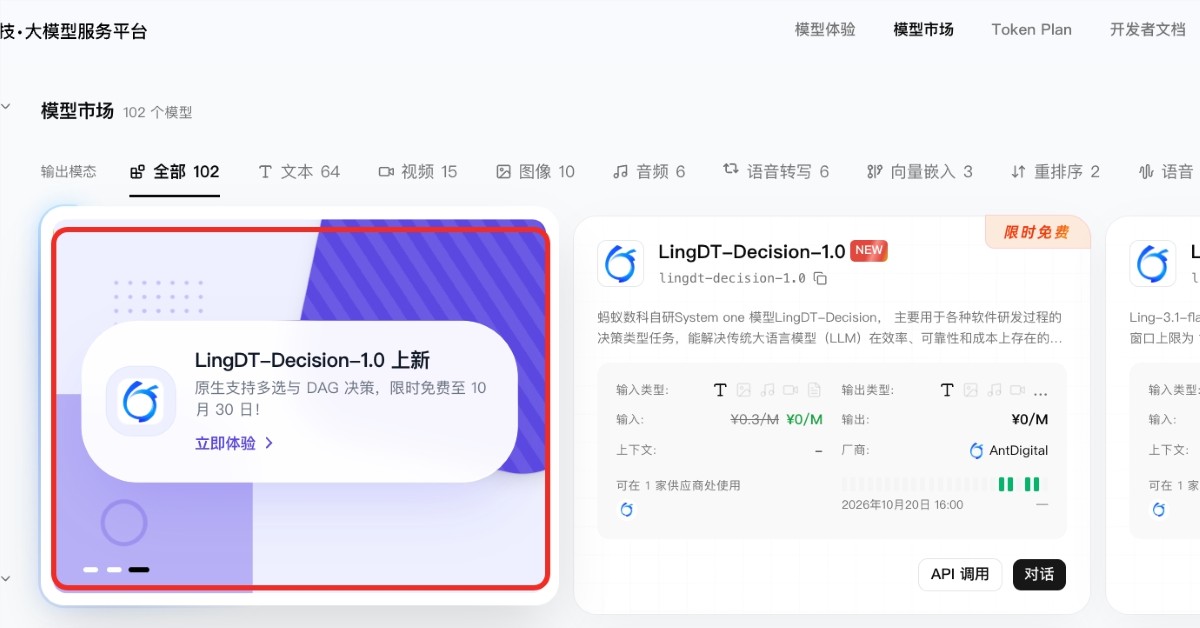
不是所有 AI 任务都需要写一段话,有些场景只需要一个准确、快速的决定。
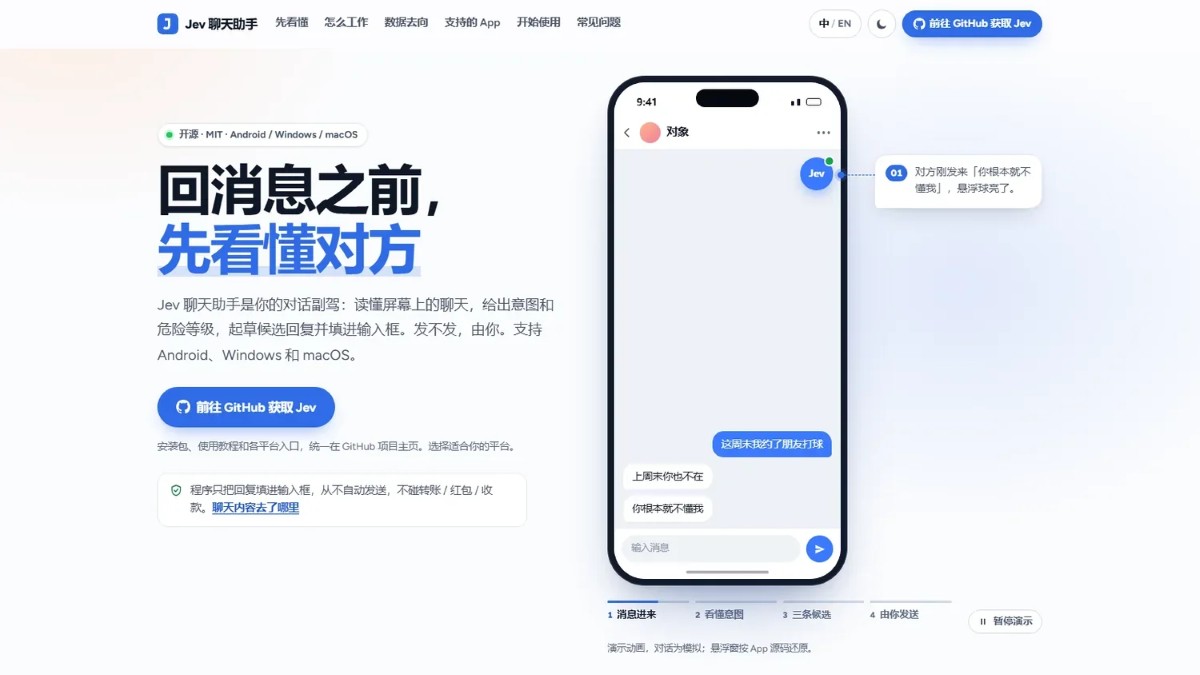
Jev 把 AI 放在聊天窗口旁边,而不是代替用户说话;“只填不发”是它最重要的产品边界。
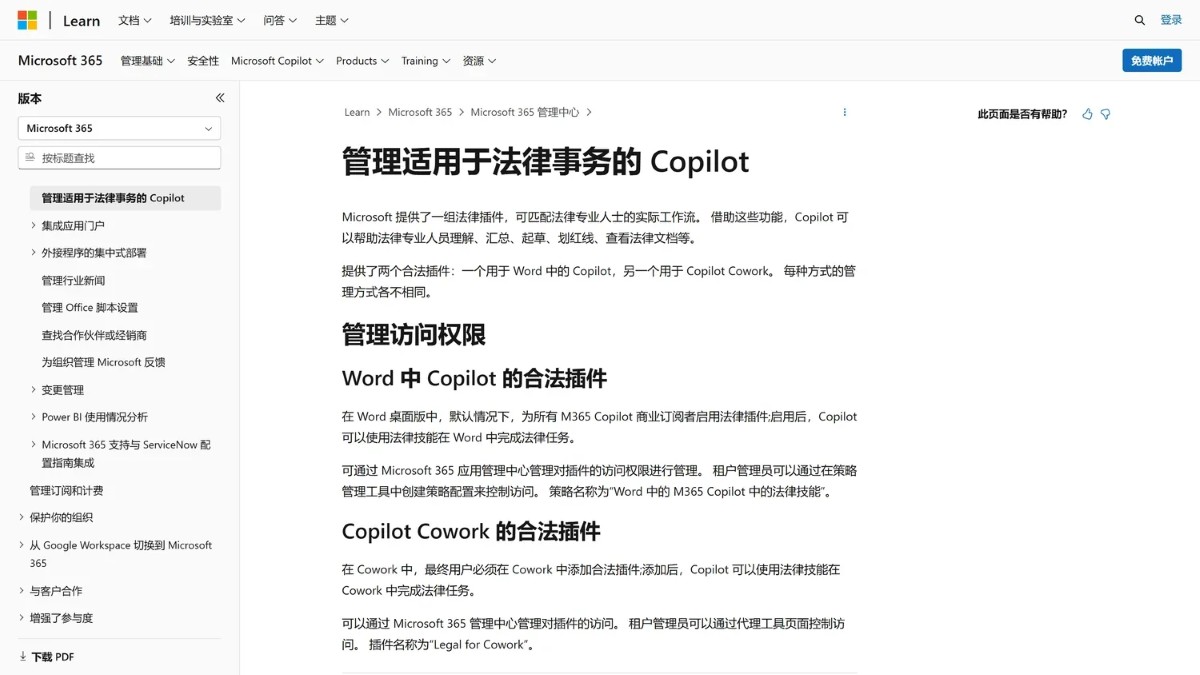
Copilot for Legal 不是独立法律软件,而是把法律技能嵌入 Word 和跨应用工作流。
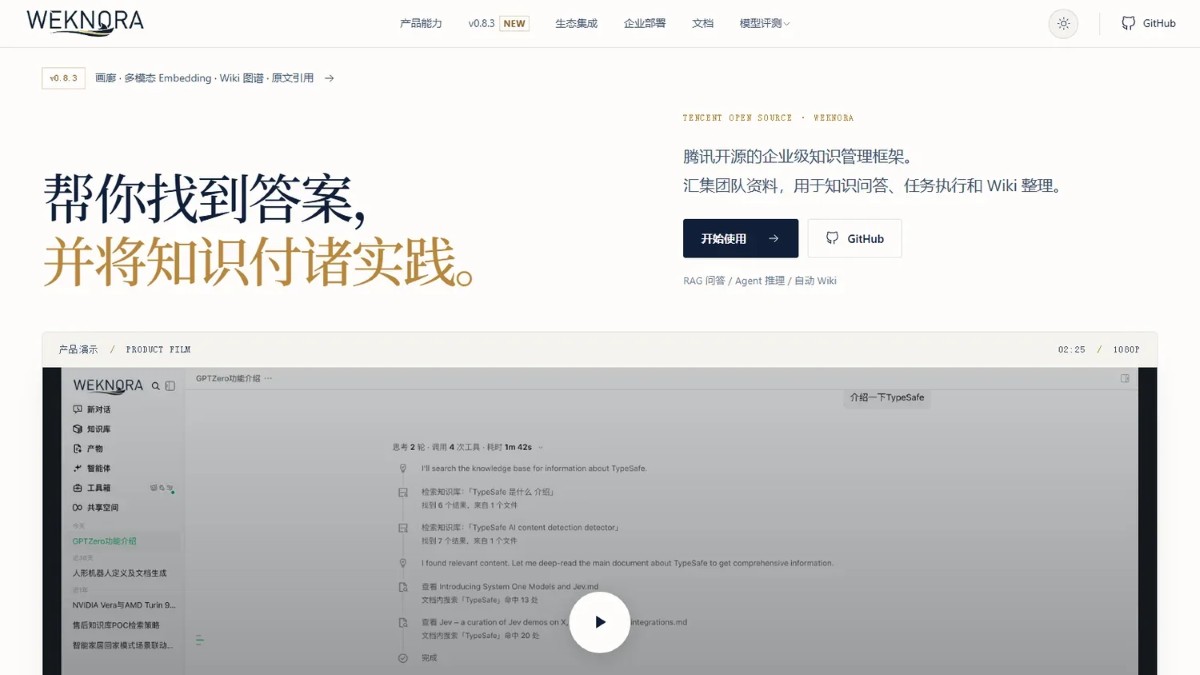
WeKnora 把 RAG、智能体和 Wiki 放在同一套知识底座上,重点是让企业文档真正被用起来。
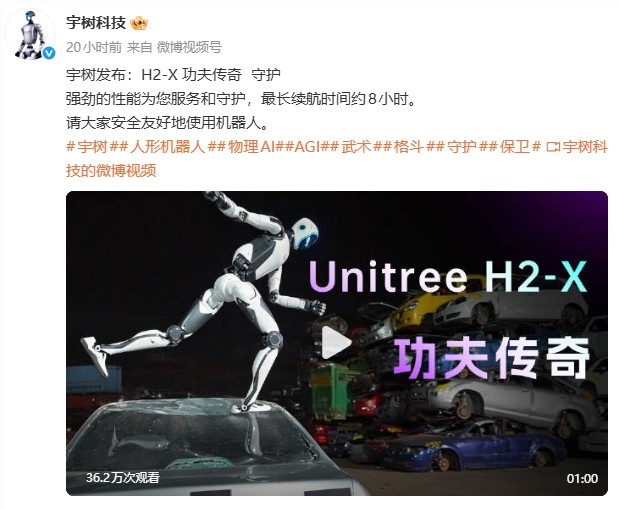
当人形机器人开始做“危险动作”,广告的边界和安全提示同样值得看。
短剧平台做到亿级日活后,下一步比的不是剧集数量,而是用户和内容之间的交互方式。
MMLU(Massive Multitask Language Understanding)覆盖 STEM、人文、社科等 57 个学科,用多选题评估模型的知识与推理能力。
Open LLM Leaderboard 用统一基准和公开提交结果,帮助开发者比较开源语言模型的综合能力。
C-Eval 由上海交通大学、清华大学和爱丁堡大学等联合推出,用中文考试题评估模型的知识理解与推理能力。
FlagEval 采用能力、任务、指标三维框架,覆盖语言、多模态等方向,并提供开放榜单和评测工具。
SuperCLUE 由 CLUE 团队维护,用统一题库和评分体系对比中文大模型的综合表现。
Jev 把机器可读判断从文本生成中独立出来,面向需要分类、评分或概率输出的应用场景。
AGI-Eval 由上海交通大学、同济大学、华东师范大学和 DataWhale 等联合维护,通过公开题库和人类评估推动模型评测透明化。
腾讯混元覆盖文本、图像、视频和 3D 生成,面向内容创作、企业服务和腾讯生态应用。
CMMLU 覆盖自然科学、人文科学、社会科学和中国生活常识等 67 个主题,并提供公开榜单与数据集。
DeepSeek R1T2 用 Tri-Mind 架构合并多个 DeepSeek 模型,在开源推理模型中强调速度与质量平衡。
MMBench 由 OpenCompass 社区主导,从感知到认知细分 20 项能力,评估多模态模型的视觉理解与推理。
Skywork-Reward-V2 提供 8 个参数规模的奖励模型,用于偏好评估、模型排序和对齐训练。
Helm Lite 用统一接口在多个场景上运行语言模型,输出可复现的指标和对比结果。
Codex 根据自然语言指令生成代码,可用于原型开发、补全、解释和代码审查。
Chatbot Arena 让用户对不同模型进行盲测投票,并通过统计模型生成动态排行榜。